大语言模型推理优化(二):Chunked Prefill
引言
在上一篇《大语言模型推理优化(一):Continuous Batching》中,我们解决了 batch 中序列长短不一的问题,做法是把不同请求拼接成一条长序列。对于 Transformer 中 MLP 这样的逐 token 计算,天然可以一次性批处理所有 token,而对于 Attention 这样的计算,可以记录每个 sequence 的起止位置,使用 Flash Attention 这样的算子库在子序列的维度上并行计算注意力。
但在实现了 continuous batching 之后,紧接着又出现了一个新的问题。大语言模型的推理分为两个截然不同的阶段,分别是 prefill 和 decode。Prefill 阶段基于输入序列计算每个 Token 的 KV Cache,Decode 阶段则针对历史生成下一个 token。当一批请求中有一个请求的 Prompt 很长时,它的 Prefill 阶段可能会长时间占用 GPU,这会导致其他请求的 Decode 阶段被阻塞。Chunked Prefill 就是为了解决这个问题而生的。这篇文章我会用尽量通俗的语言,把这个问题讲清楚,再解释 Chunked Prefill 是如何化解它的。
LLM 推理的两个阶段
在介绍 Chunked Prefill 之前,我们先回顾一下大语言模型推理的两个阶段,即预填充(Prefill)和解码阶段(Decode)。
Prefill 阶段对输入的所有 token 进行前向计算,在这期间会将每个 token 的 Key 和 Value 存入 KV Cache。由于用户的输入可能非常长,因此 Prefill 阶段的计算量通常很大。可以把 Prefill 想象成“读题”,无论题目多长,模型都需要先完整地阅读一遍才能开始生成回答。
Prefill 结束后会进入 Decode 阶段,模型开始逐 token 地生成。每生成一个新 token,模型会使用 KV Cache 中的 Key 和 Value 来计算注意力,并将新生成的 token 的 Key 和 Value 追加到缓存中。Decode 阶段可以类比为“答题”,模型一次只生成一个 token,但每次生成都需要参考之前的所有内容。
Prefill 阶段一次处理成千上万个 token,主要计算是矩阵乘矩阵,计算量很大,GPU 的计算单元被充分利用,是典型的计算密集型(compute-bound)任务。Decode 阶段每一步每个请求只处理 1 个 token,计算是矩阵乘向量,计算量很小。但为了计算这 1 个 token,模型需要把大量的权重和 KV Cache 从显存里搬进计算单元,大部分时间花在搬数据上,是典型的访存密集型(memory-bound)任务。
如果分阶段来完成 Prefill 和 Decode,在 Prefill 阶段,GPU 的计算单元可以被充分利用,而在 Decode 阶段,GPU 的计算单元大部分时间会处于闲置状态。而且如果有一个请求的输入过长,它的 Prefill 阶段可能会长时间占用 GPU,导致其他请求的 Decode 阶段被阻塞。
Chunked Prefill 的原理
Chunked Prefill 的思路简单很简单,从字面上也能猜到其实现原理:把之前一次执行的 prefill 阶段拆分成多次执行,每次只处理一小块 token。即每次 prefill 只处理一部分输入,而不是一次性处理完整的输入。这样可以避免 prefill 阻塞 decode。相当于对每一个请求都至多分配固定的计算量,对于输入较长的请求可以分多次完成 prefill,后果就是整个 prefill 的耗时会更长一点,但好处是每次 prefill 的计算量被限制住了,单步耗时稳定、可控。这样其他请求的 decode 阶段就不会被阻塞,用户体验更好。
具体做法是,调度器规定每一次 prefill 最多处理固定数量的 token,比如 2048 个,这个数量叫做 chunk size。假如一个请求有 10000 个 token,这 10000 个 token 会被切为 5 块,每一块和其他请求的 decode 混在同一个 batch 里。下面中包含 A、B、C 三个请求,其中 A、B 正在处于 decode 阶段,C 处于 prefill 阶段,下图为调度器的调度流程:
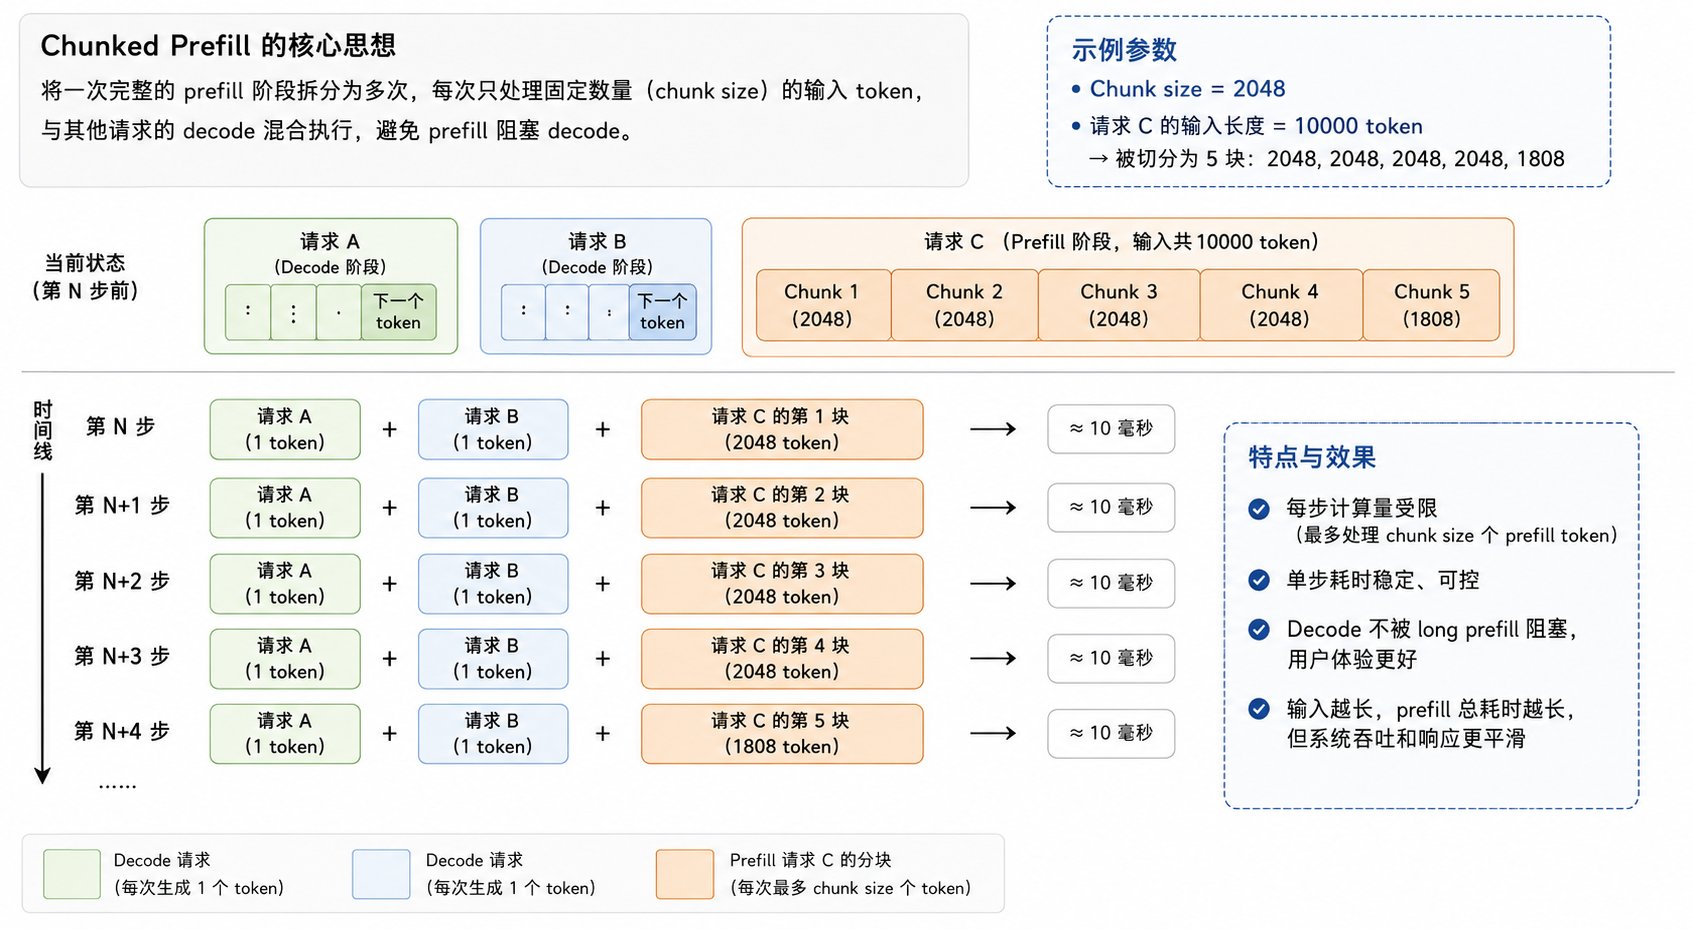
整个调度循环中,A、B、C 三个请求的计算量被限制在 chunk size 之内。每一步,调度器会同时处理正在 decode 的请求 A 和 B,和处于 prefill 阶段的请求 C 中至多 2048 个 token。这样,A 和 B 就不会被 C 的长时间阻塞。
调度器做的事情很简单,每一步的 batch 由 Decode 请求的 1 个 token 和 Prefill 请求的一个 chunk 组成:
CHUNK_SIZE = 2048
tokens = []

# 每个 decode 请求贡献 1 个 token
for req in decode_requests:
    tokens.append(req.last_token)

# 每个 prefill 请求只贡献一块(不超过 CHUNK_SIZE 个 token)
for req in prefill_requests:
    tokens.extend(req.next_chunk(CHUNK_SIZE))

forward(tokens)  # 做一次 forward,然后组装下一步的 batch
实际的实现中还涉及到 KV Cache 的分页管理,注意力计算等细节,但核心逻辑和上一篇讲的 continuous batching 一脉相承。唯一的区别是 chunked prefill 中,Prompt 不再一次性进入 batch,而是一块一块地被处理。
Chunked Prefill 的注意力计算
分块执行 Prefill 不会改变结果,这只是将原来一次性执行的 Prefill 拆分成多次执行。在 GPU 上,Chunked Prefill 的注意力计算和上一篇讲的 continuous batching 是一样的:把所有请求拼成一条长序列,用累积长度数组记录每个段的边界,然后在子序列的维度上并行计算注意力。唯一的区别是,段的长度不再都是 1——Decode 段是 1 个 token,Prefill 段最多是 chunk size 个 token。
组装长序列
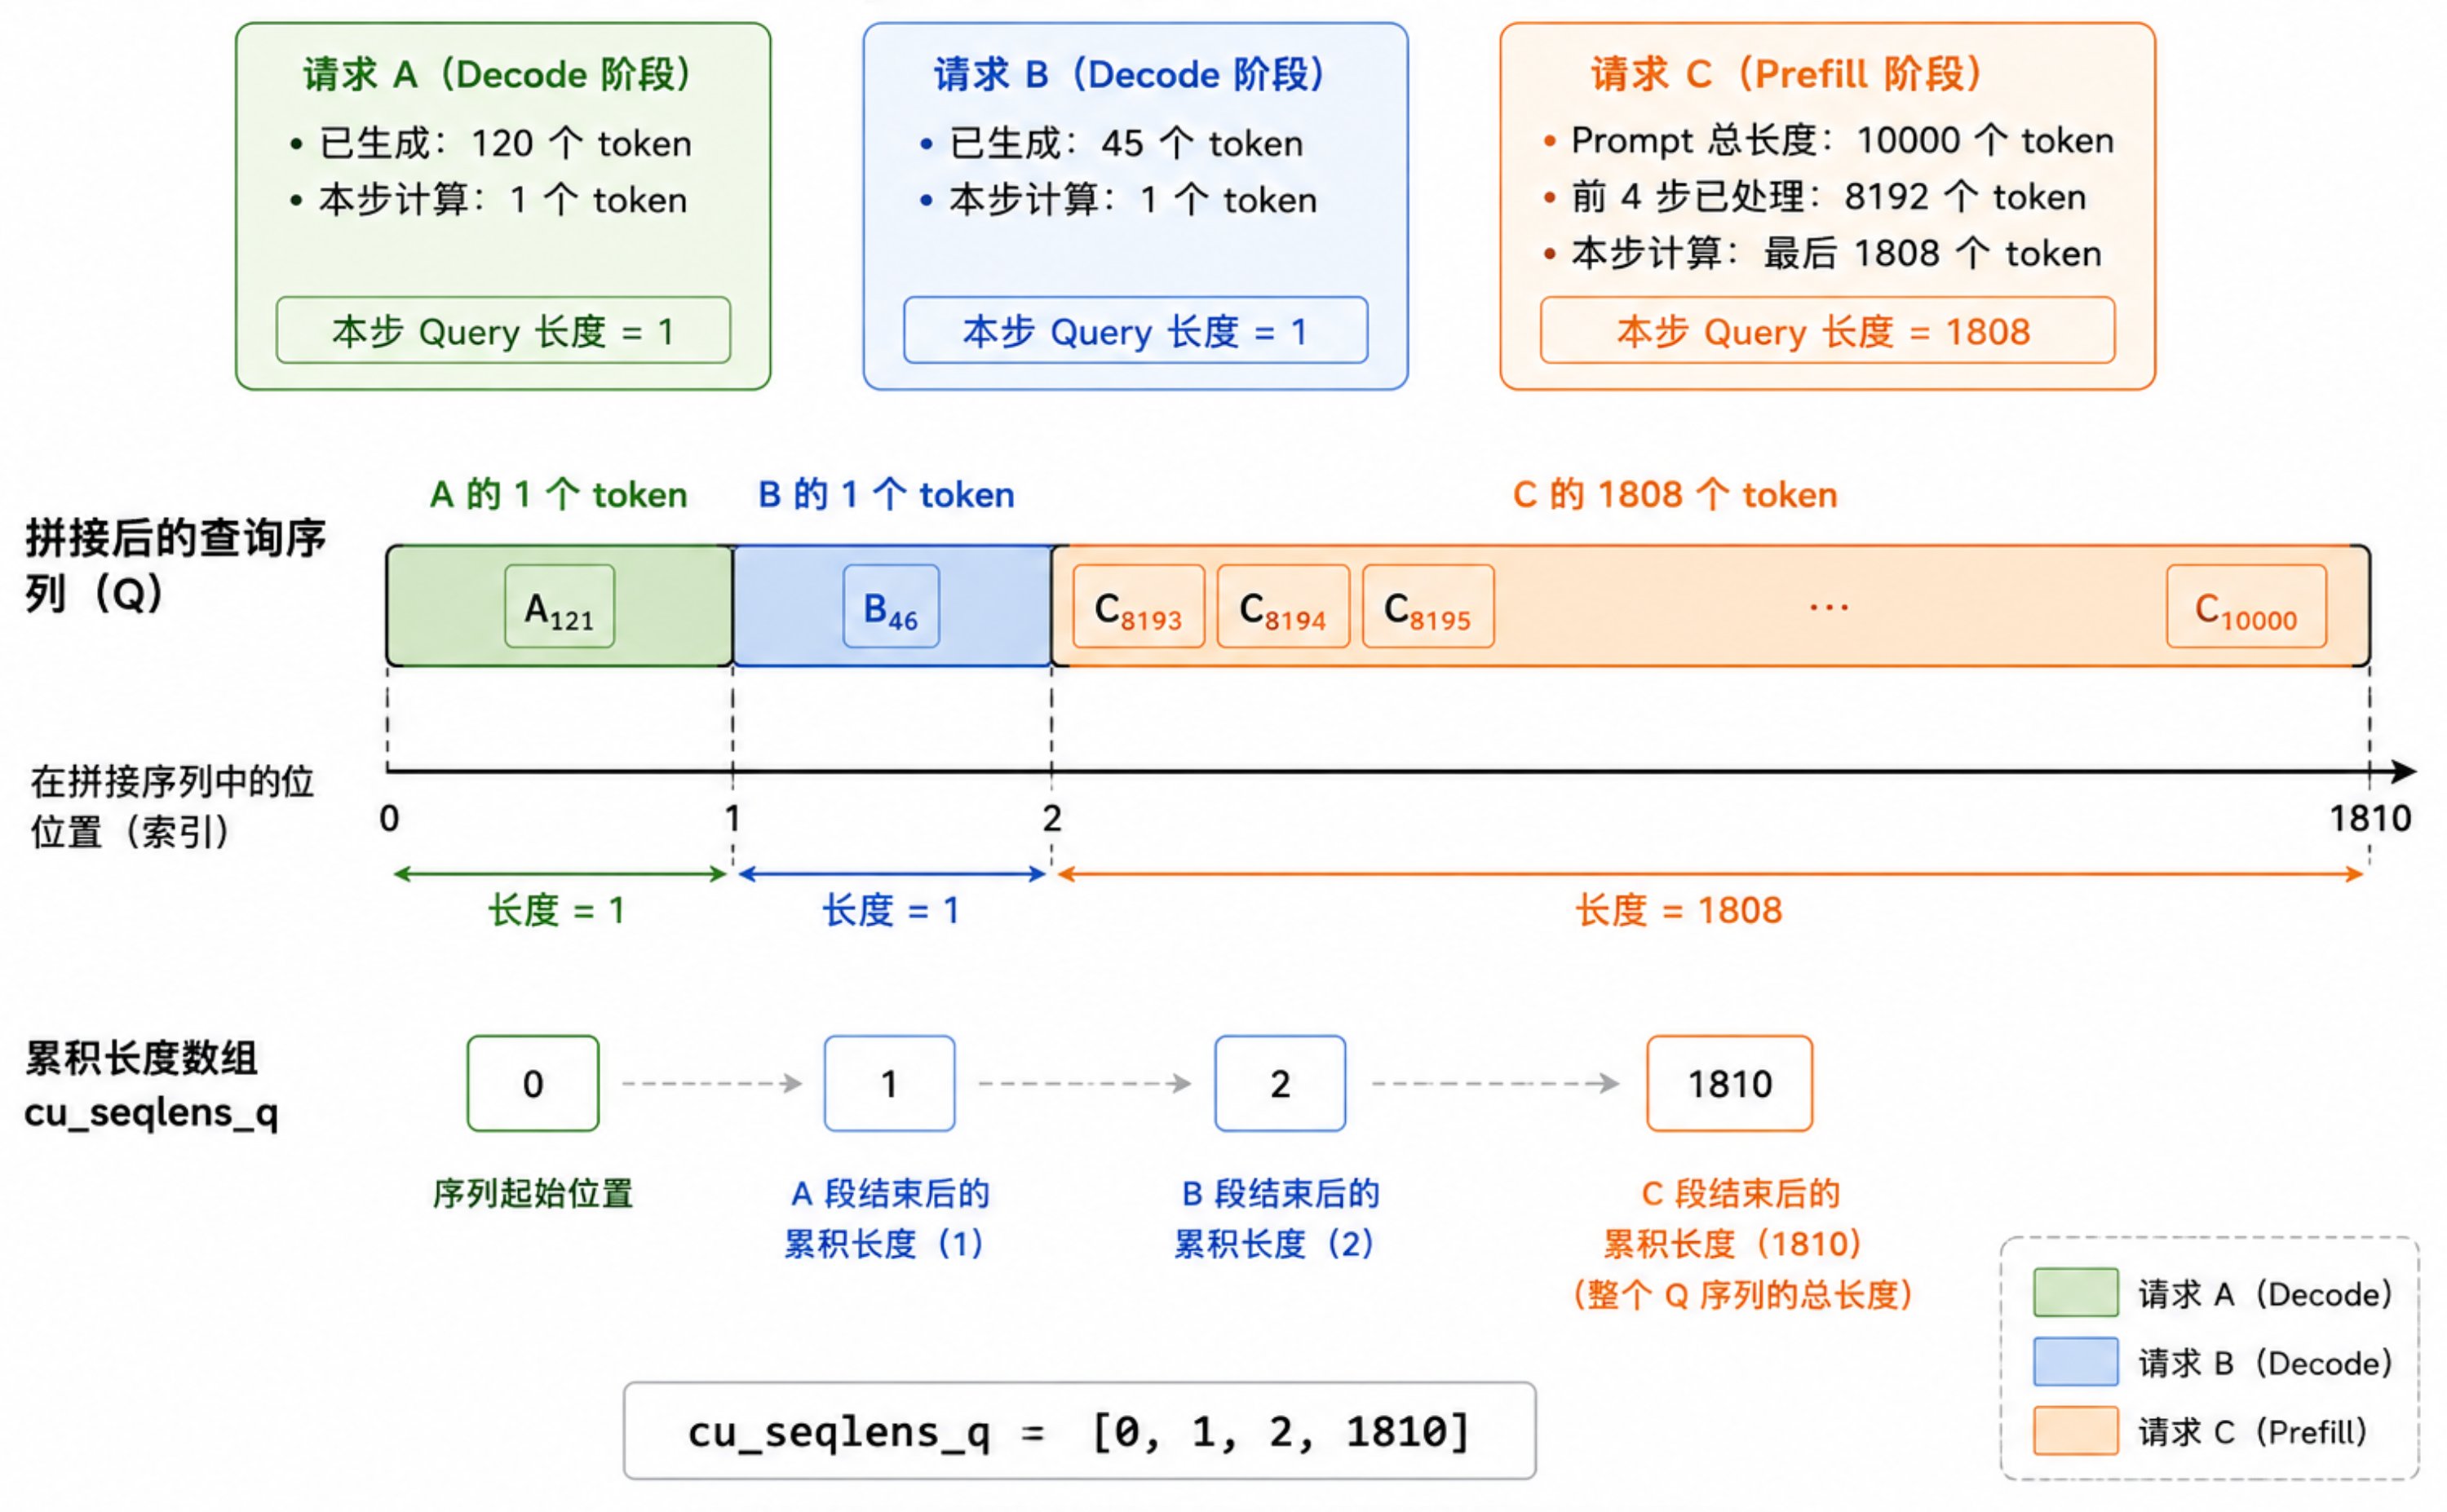
Chunked Prefill 不是把 Attention 算法改了,而是把一次巨大的 Prefill 工作拆成多个较小的 Attention 工作,并把这些工作穿插到 Decode 请求之间。举个具体的例子,假设这一步处理 3 个请求:
- 请求 A:处于 Decode 阶段,已经生成了 120 个 token,这一步再算 1 个
- 请求 B:处于 Decode 阶段,已经生成了 45 个 token,这一步再算 1 个
- 请求 C:处于 Prefill 阶段,Prompt 共 10000 个 token,前 4 步已经处理了 8192 个,这一步处理最后 1808 个
下图为这三个请求拼接成的长序列后的示意图:
记录 KV Cache 的长度
每个请求在每一步的注意力计算中,能看到的历史长度是不同的。上面例子里,请求 A 当前正在处理的这个 token 需要看到 120 个历史 token 和自己本身,共计 121 个 token;请求 B 类似,需要看到 45 个历史和自己本身,共计 46 个 token;请求 C 的 1808 个新 token 需要看到:8192 个历史 + 块内排在各自前面的部分。
所以每个段需要记录两个数字,一个是当前需要处理的 token 数,另一个是历史长度。在 vLLM 里,这两个数字分别被记录在 cu_seqlens_q 和 cu_seqlens_k 两个累积数组里:
画图描述 cu_seqlens_q 和 cu_seqlens_k 这两个数组的构成
| 字段 | 说明 | 示例 |
|---|---|---|
cu_seqlens_q | 每个段的查询长度(当前要处理的 token 数) | [0, 1, 2, 1810] |
cu_seqlens_k | 每个段的 KV 长度(历史 + 当前要处理的 token 数) | [0, 121, 167, 10167] |
cu_seqlens_q 和 cu_seqlens_k 本质是记录 q 和 k/v 的段边界,因为一个 batch 中的所有序列都被拼接在了一起,所以在计算的时候需要这个信息来找到每个请求的 q 和 k/v 的起止位置。
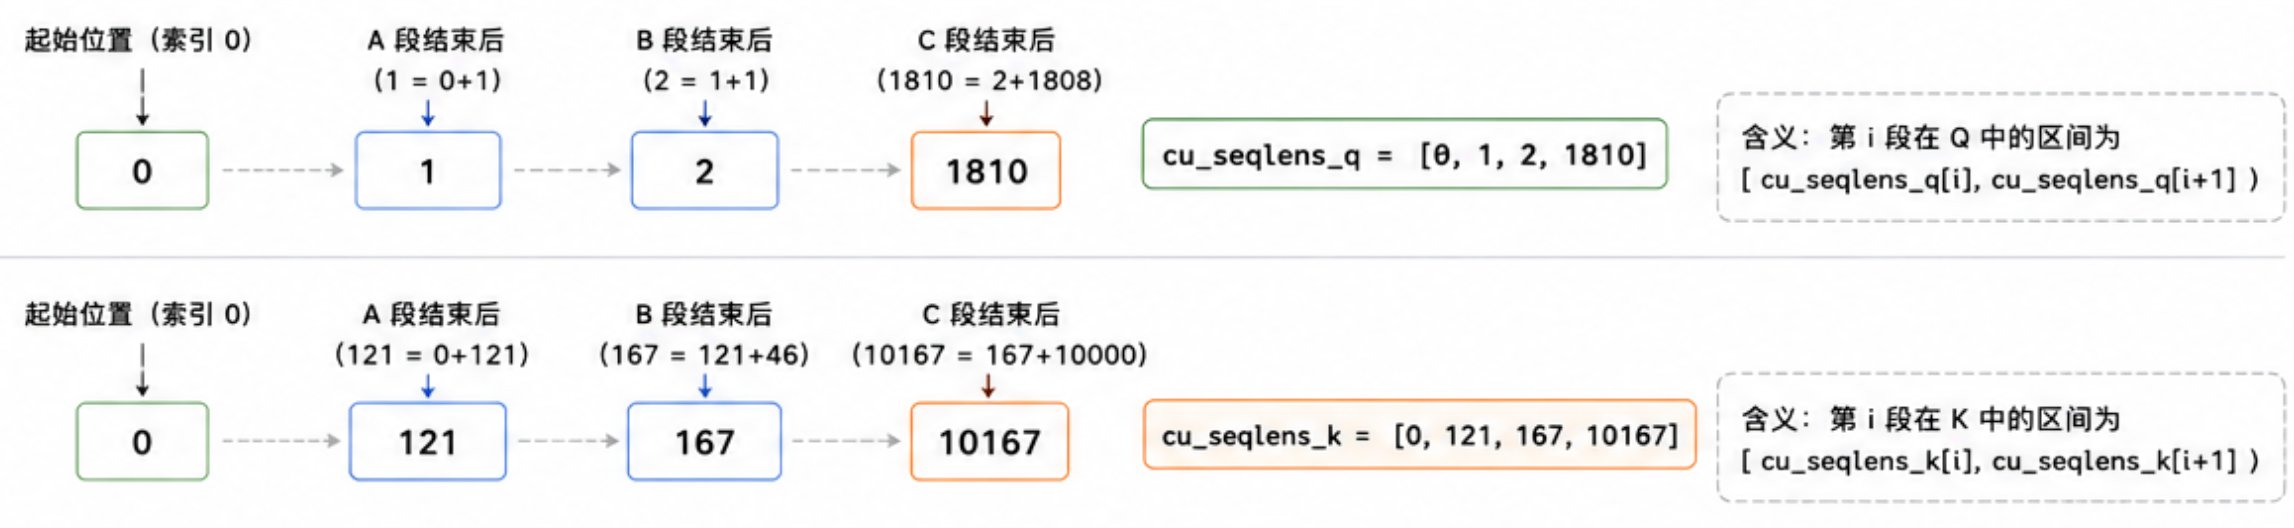
上面例子中 cu_seqlens_q 的取值为 [0, 1, 2, 1810],表示第一个段(请求 A)在拼接后的序列中的范围是 [0, 1),第二个段(请求 B)是 [1, 2),第三个段(请求 C)是 [2, 1810)。cu_seqlens_k 的含义类似,表示第一个段的 KV 范围是 [0, 121),第二个段是 [121, 167),第三个段是 [167, 10167)。
Flash Attention 的 varlen 接口
上一篇提过,Flash Attention 用 cu_seqlens 把拼接后的序列切分成段,每个线程块计算一个段的注意力。处理这种每段历史长度不同的混合 batch,用的是它的 varlen(变长)接口:
out = flash_attn_varlen_func(
    q,               # 这一步所有新 token,拼接后
    k, v,            # 对应的 K/V(包含历史部分)
    cu_seqlens_q,    # [0, 1, 2, 1810]
    cu_seqlens_k,    # [0, 121, 167, 10167]
    max_seqlen_q,    # 最长的查询段:1808
    max_seqlen_k,    # 最长的 KV 段:10000
    causal=True,
)
两个累积数组把 q 和 k/v 分别切分成同样多的段,第 i 个查询段只和第 i 个 KV 段做注意力,完全看不到其他请求。
在 causal=True 的实现方式上,Flash Attention 把查询段右对齐到 KV 段的末尾,每个 token 只能看到它自身和前面的 token。上面例子中:
- 对 Decode 段 A:查询 1 个 token,KV 121 个,右对齐后这个 token 能看到全部 121 个位置——正是我们想要的。
- 对 Prefill 段 C:查询 1808 个,KV 10000 个。块内第 1 个 token 能看到全部 8192 个历史 + 自己;块内第 i 个 token 能看到全部 8192 个历史 + 块内前 i 个 token。恰好满足"每个 token 只能看到它前面的 token"的规则。
在同一次 kernel 调用里,Prefill 和 Decode 其实不是两种不同的计算,它们只是长度不同的注意力段。查询长度为 1 的是 Decode,查询长度大于 1 的是 Prefill。GPU 并不关心请求的身份,它只是按照两个累积数组一段一段地算注意力。这正是混合 batch 能在计算层面成立的原因。
Chunked Prefill 的性能收益
Chunked Prefill 除了让 ITL(Inter-Token Latency)更平稳之外,它还能提升整体吞吐量。Decode 是访存密集型任务,为了算 1 个 token,需要把大量权重和 KV Cache 从显存搬进计算单元,计算单元大部分时间在闲着。单看 Decode 步骤,GPU 的算力其实并没有被充分利用。
而 Prefill 是计算密集型任务,恰好能把这些闲着的计算单元填满。Chunked Prefill 把 Prefill 切成块混进 Decode 的步骤里,搬运的权重和 KV Cache 在 prefill 和 decode 之间共享,同时 Decode 的访存密集型任务和 Prefill 的计算密集型任务实现了重叠。整体算下来,GPU 的利用率上去了,系统单位时间能处理的总 token 数(吞吐量)也跟着上去了。Chunked Prefill 并不是简单地牺牲 Prefill 的速度保 Decode 的体验,而是让两种任务互相填空,整体反而更快。
2023 年的一篇论文 Sarathi(Efficient LLM Inference by Piggybacking Decodes with Chunked Prefills,Agrawal 等人,arXiv:2308.16369)。"chunked-prefill" 这个词就是出自它,论文还给混合 batch 起了一个更具体的名字:decode-maximal batching——一个 batch 里放一块 prefill,剩下空位全部塞满 decode token,让 decode"搭便车"(论文管这叫 piggybacking)。这项工作后来被收录进了系统顶会 OSDI 2024。
我挑几个论文里的数字,看看收益到底有多大。论文在真机上做了实验:LLaMA-13B 跑在 A6000 上,LLaMA-33B 跑在 A100 上。
第一,两个阶段的差距比想象中更悬殊。 在 LLaMA-13B + A6000 上,batch size 为 1 时,Decode 的每 token 成本大约是 Prefill 的 200 倍;即使把 batch 加大到 18,差距仍然有 16.7 倍。Prefill 的每 token 成本几乎不随 batch 变化(512 个 token 就已经把 GPU 算力打满了),而 Decode 要到 batch 256 左右才能把算力打满——可惜受 KV Cache 显存限制,1K 序列长度下最多只能容纳 18 个并发请求。这就是前面"Prefill 计算密集、Decode 访存密集"这句话的量化版本。
第二,"搭便车"的效果是实打实的。 论文 Table 2 对比了三种情况下一轮迭代的耗时(LLaMA-13B @ A6000):
| batch 组成 | 整步总耗时 | Decode 每 token 耗时 |
|---|---|---|
| 纯 Decode(4 个请求) | 49.96 ms | 12.49 ms |
| 1021 个 Prefill token + 3 个 Decode | 238.4 ms | 1.2 ms |
| 纯 Prefill(1024 个 token) | 234.8 ms | — |
这张表值得看两遍。先看中间一行:混合 batch 的总耗时(238.4 ms)只比纯 Prefill batch(234.8 ms)多了 3.6 ms——3 个 Decode 请求搭了便车,这一步的总成本几乎没有增加;但 Decode 的每 token 成本从 12.49 ms 降到了 1.2 ms,提升了将近一个数量级。这正是"把闲着的算力用起来"的机制:模型权重本来就要为 Prefill 加载进计算单元,Decode token 顺势融进同一次矩阵乘法,从访存密集变成了计算密集。
再注意一个细节:1021 + 3 = 1024,恰好是 128 的整数倍。这不是巧合,下一节会解释。
第三,端到端的收益。 单 GPU 真机实测:
| 模型 / GPU | Decode 吞吐 | 端到端吞吐 |
|---|---|---|
| LLaMA-13B @ A6000 | 最高 10×(各配置下 2.8×–10×) | 最高 1.33× |
| LLaMA-33B @ A100 | 最高 4.25× | 最高 1.25× |
你可能会问:Decode 提升了 10 倍,为什么端到端只有 1.3 倍?论文给了很坦诚的解释:这项技术只优化了 Decode 部分,Prefill 并没有变快,而很多负载里 Prefill 占了总时间相当大的比例,整体收益自然被摊薄了。这也是推理优化"处处是权衡"的一个典型注脚。
作为参照,论文还和当时最先进的 Orca 迭代级调度做了对比(vLLM、TGI 等系统沿用的就是这套调度范式):Orca 的最好情况也只有 1.11× 的提升,Sarathi 在三种序列长度下分别拿到 1.27×、1.25×、1.23×,稳定领先。
第四,一个附带的福利:流水线并行。 在模拟的 64 张 A100 集群上部署 GPT-3(机内 8 路张量并行 × 机间 8 路流水线并行),混合 batch 还有一个额外好处——每一步的计算量几乎相同,流水线各级之间的"气泡"(空等时间)因此减少了 6.29 倍,端到端吞吐提升 1.91×。Chunked Prefill 不只是单卡的技巧,它还能让多机部署变得更高效。
Chunk size 该选多大
Chunk size 是 Chunked Prefill 里最重要的一个旋钮,它本质上是延迟和吞吐之间的权衡:
- chunk 切得小(比如 512):每步计算量少,ITL 非常平稳,用户体验丝滑。但步骤数变多,每步的调度、算子启动等固定开销会被放大,计算密集型任务的占比也低了,GPU 利用率会打些折扣。
- chunk 切得大(比如 8192):每步能塞进更多 Prefill 计算,GPU 利用率更高,吞吐更好。但每步耗时变长,ITL 会相应升高。
Sarathi 论文提供了不少实测依据。在 LLaMA-13B + A6000 上:chunk size 取 512 以上时 Prefill 吞吐达到峰值,取 256 只低 12.5%(论文实验大多用 256),而切到 64 会让注意力计算慢 3 倍、整个 Prefill 慢 5 倍。
上一节那个"1024 恰好是 128 的整数倍"的细节,在论文里有个名字:tile 量化(tile quantization)。GPU 做矩阵乘法时会把矩阵切成一个个小方块(tile,论文实验环境中边长为 128)分给不同的线程块并行计算,只有当序列长度恰好是 tile 的整数倍时每个线程块干的活才一样多。论文实测:257 个 token 的计算时间比 256 个 token 多出 32%——仅仅多 1 个 token,耗时涨了三成。所以生产系统里,每一步的总 token 数(chunk + 搭车的 decode token)通常会刻意对齐到 tile 边界。
论文还给了一个挑选 chunk size 的经验公式:当 batch 内 P:D 比例(Prefill token 数 : Decode token 数)约等于 chunk size ÷ (batch size − 1) 时,Decode token 恰好能被 Prefill 块完全覆盖,收益最大。比如 batch size 18、chunk 256 时,P:D 约为 15 附近收益最高(1.27×)。负载是"短问题长回答"(P:D 低)就用小一点的 chunk,"长上下文短回答"(P:D 高)就用大一点的 chunk。
另一个硬件层面的差别:A100 的算力/带宽比(约 156)远高于 A6000(约 53),意味着 A100 需要更长的序列才能把算力打满,所以在 A100 上通常要用更大的 chunk 才不损失 Prefill 效率。
最后说明一下:论文的实验环境是 2023 年的单卡部署、1K–3K 的序列长度,所以它用的 chunk 偏小(256/512)。如今生产系统里 chunk 的常见取值已经到了几千甚至上万个 token(比如 1024、2048、8192、16384),这既和新一代 GPU 算力/带宽比的提升有关,也和长上下文场景的普及有关。
和 Prefill/Decode 分离的关系
Chunked Prefill 是调度层面的解法:在同一组 GPU 上让 Prefill 和 Decode 和平共处。还有一种更"彻底"的思路:把 Prefill 和 Decode 物理上分开,部署在不同的 GPU 上——一组节点专门处理长 Prompt,另一组节点专门生成回答,两者之间传输 KV Cache。这种做法叫做 Prefill/Decode 分离(PD Disaggregation)。
两者各有取舍:Chunked Prefill 实现简单,不需要额外的硬件拓扑,是大多数场景的默认选择;PD Disaggregation 隔离更彻底,但需要跨机传输 KV Cache,工程复杂度更高,通常用在超大规模的部署里。
目前主流的推理框架(vLLM、SGLang、TensorRT-LLM 等)都已经把 Chunked Prefill 作为默认或可选的调度策略。
在 vLLM 中是如何实现的
前面几节把原理和收益讲完了,最后一节来看具体的工程落地。上一节提到主流推理框架都已经内置了 Chunked Prefill,这里就以用得最多的 vLLM 为例,对照源码讲一遍,文中的代码做了大量简化,完整版可以点链接去看。
Token 预算:max_num_batched_tokens
vLLM 中 chunked prefill 的核心是一个"每步 token 预算":max_num_batched_tokens,表示一次 forward 最多处理多少个 token。Decode 请求每个消耗 1 个,Prefill 请求消耗它这一步要处理的那一块的 token 数,预算用完,这一步就不再调度更多 token 了。
默认值不是固定的,vLLM 会根据 GPU 显存和使用场景自动选择:比如 A100 上离线批量推理是 8192,作为 API 服务是 2048;H100、B200 这类高显存卡可以高到 16384。也可以用 --max-num-batched-tokens 手动指定。
版本上,v0.6.0(2024 年)开始用 --enable-chunked-prefill 显式开启这个特性;更新的 V1 引擎(近期版本的默认引擎)里,基于 token 预算的调度就是默认行为,enable_chunked_prefill 默认为 True。
这里有个和 Sarathi 论文不一样的细节值得注意:vLLM 没有"chunk size"这个配置项。论文里是把 Prefill 切分成等大的块,vLLM 则是"预算驱动"的:这一步的块大小 = min(Prompt 剩余长度, 这一步的剩余预算)。batch 里只有一个 Prefill 请求时,块大小就是预算本身;有几个 Decode 请求在,Prefill 的块就会被挤掉几个 token。所以"块"不是一个固定大小的东西,而是一个跟着预算走的东西。
调度器:running 优先,waiting 填充
调度器每一步都会跑一轮调度(V1 引擎的源码),核心逻辑简化后是这样的:
token_budget = max_num_batched_tokens  # 这一步的 token 预算

# 第一遍:running 里的请求(已经在 batch 中的)优先
for req in running:
    # 剩余待处理的 token 数:
    # num_tokens = prompt 长度 + 已生成的回答数(decode 阶段每步 +1)
    # num_computed_tokens = 已经过模型的 token 数
    # 于是:decode 请求剩下 1 个新 token,prefill 请求剩下"没读完的 prompt"
    n = req.num_tokens - req.num_computed_tokens
    if 0 < long_prefill_token_threshold < n:
        n = long_prefill_token_threshold
    n = min(n, token_budget)
    schedule(req, n)
    token_budget -= n

# 第二遍:waiting 队列里排队的新请求,用剩余预算填充
# 新请求还没生成过任何 token,num_tokens == num_prompt_tokens
while waiting and token_budget > 0:
    req = waiting.pop()
    n = min(req.num_prompt_tokens, token_budget)
    if n > 0:
        schedule(req, n)   # 新请求也是"一块一块"进 batch
        token_budget -= n
三个关键点:
- 每个请求都记着
num_computed_tokens——已经过模型的 token 数(Prompt 部分 + 已生成的回答部分,Decode 阶段每步也在增长)。num_tokens则是"Prompt 长度 + 已生成回答数",两者相减就是剩余待处理的量:Decode 请求剩 1 个,正在 Prefill 的请求剩没读完的 Prompt。一个公式同时覆盖两种请求,这是前面 running 队列里能混着调度它们的原因。所以"切块"并不是显式地把 Prompt 切成 N 份,而是 token 预算的自然结果:这一步预算只够 2048,就先算 2048,剩下的留给下一步。注意,一个没读完 Prompt 的请求会留在 running 队列里,之后的每一步都会被继续调度,直到 Prompt 读完为止——这就是 chunked prefill 在 vLLM 里的真实形态。 - running 优先、waiting 填充:这一步先处理 running 队列里的请求(包括正在 Decode 的,也包括上一轮没读完 Prompt、还在 Prefill 的),队列处理完还有预算,才轮到 waiting 里排队的新请求。running 队列内部其实是先来先得:按请求进入队列的先后排序,并不是"所有 Decode 都优先于 Prefill"的硬规则。Decode 请求通常排在前面,只是因为它们进队列的时间更早(Prefill 早在好几十步之前就完成了)。预算不够时,排在后面的请求会被整体推迟到下一步。
long_prefill_token_threshold:默认 0(不限制)。可以设成比如 1024,意思是超过阈值的长 Prompt,每一块最多 1024 个 token——防止一个 10 万 token 的 Prompt 第一块太大,把这一步的延迟拉高。
顺带说一句:很多场景下 chunked prefill 其实是"隐身"的。预算默认有 8192 甚至 16384,而不少请求的 Prompt 只有几百到几千个 token,一个 Prefill 一步就算完了,根本轮不到切块。只有 Prompt 很长、或者并发请求很多把预算挤占光的时候,才会真正看到分块的效果。
输入组装:前面讲过的那几个数组
模型执行器把这一步调度出来的 batch 组装成前面讲过的数组格式。在 V1 引擎里,这些数组集中在一个 FlashAttentionMetadata 结构体里(源码):
| 字段 | 对应前面讲过的概念 |
|---|---|
query_start_loc | cu_seqlens_q:每个请求这一步新 token 的累积长度 |
seq_lens | 每个请求可见的 KV 长度 = 历史 + 本步新 token |
block_table | 逻辑位置 → 物理页的映射 |
slot_mapping | 本步新 K/V 要写进分页缓存的位置 |
执行顺序是:先算出新 token 的 Q/K/V,用 slot_mapping 把新 K/V 写进分页缓存,然后带着上面的元数据调用 Flash Attention 的 varlen 分页 kernel(causal=True,右对齐掩码),kernel 内部按 block_table 从各页里取历史 K/V。这就是前面 flash_attn_with_kvcache 式接口的真实形态。
采样:只有该出字的请求才出字
输出层只对每个段的最后一个位置计算 logits(源码):
# 每个段的最后一个位置
logits_indices = query_start_loc[1:] - 1
之后,采样器只给"Decode 请求"和"这一步恰好读完 Prompt 的 Prefill 请求"真正采样出 token,其他 Prefill 中间块算出来的 logits 会被直接丢弃。
把 vLLM 的实现串起来看:token 预算管"这一步算多少 token",num_computed_tokens 管"每个请求进行到哪了",四个数组描述"注意力怎么切段",Flash Attention kernel 负责真正的计算,采样器决定"谁这一步出字"。前面几节讲的概念,在这里一一对应上了。
总结
上一篇的 continuous batching,让不同长度的请求能够高效地共享同一块 GPU;这一篇的 Chunked Prefill,解决的是"新请求的长 Prompt 处理过程会阻塞已有请求的生成"的问题:把长 Prompt 切成小块,混着 Decode 一步一步地处理,既让用户看到的回答平滑不卡顿,又把 GPU 闲着的算力填了起来,延迟和吞吐量各得其所。
推理优化的故事还远没有结束。Continuous Batching 和 Chunked Prefill 都只是调度层面的"基本功",KV Cache 管理、投机解码(Speculative Decoding)、量化等方面还有大量值得展开的话题,我们下篇见。