大语言模型量化技术(四):SmoothQuant
从 W4A16 到 W8A8
前两篇介绍的 GPTQ 和 AWQ 都是权重量化方法,量化后权重为 4 bit,激活保持 16 bit,也就是 W4A16。这类方法主要减少权重的显存占用和读取带宽,在单次请求或小批量解码场景下收益明显,因为此时推理的瓶颈是将权重从显存搬到计算单元。
但推理并不总是受带宽限制。当批量较大或处于 prefill 阶段时,一次需要处理许多 token,权重搬运的成本被摊薄,瓶颈便转移到矩阵乘法的计算吞吐上。这时 W4A16 的帮助有限:激活仍是 FP16,矩阵乘仍需使用 FP16 Tensor Core,单纯降低权重位宽并不会加快这次 FP16 矩阵乘。
要让计算本身变快,就需要把权重和激活都量化到 INT8,用 INT8 的 Tensor Core 做矩阵乘。在 NVIDIA 的 Hopper 架构上,INT8 的计算吞吐是 FP16 的两倍,这是 W8A8 的吸引力所在。
要实现高效的 W8A8 推理,不仅需要量化权重,也需要量化激活。激活值的分布通常比权重更分散,其中少量幅值特别大的异常值会增加量化难度。本文介绍的 SmoothQuant 正是为了解决激活异常值导致的量化困难而提出的。
激活量化的难点
我分析了 Qwen3-0.6B 模型的权重和激活分布。可以看到,模型权重的分布相对集中,大部分权重的数值都在较小的范围内。下图展示了部分权重的数值分布:
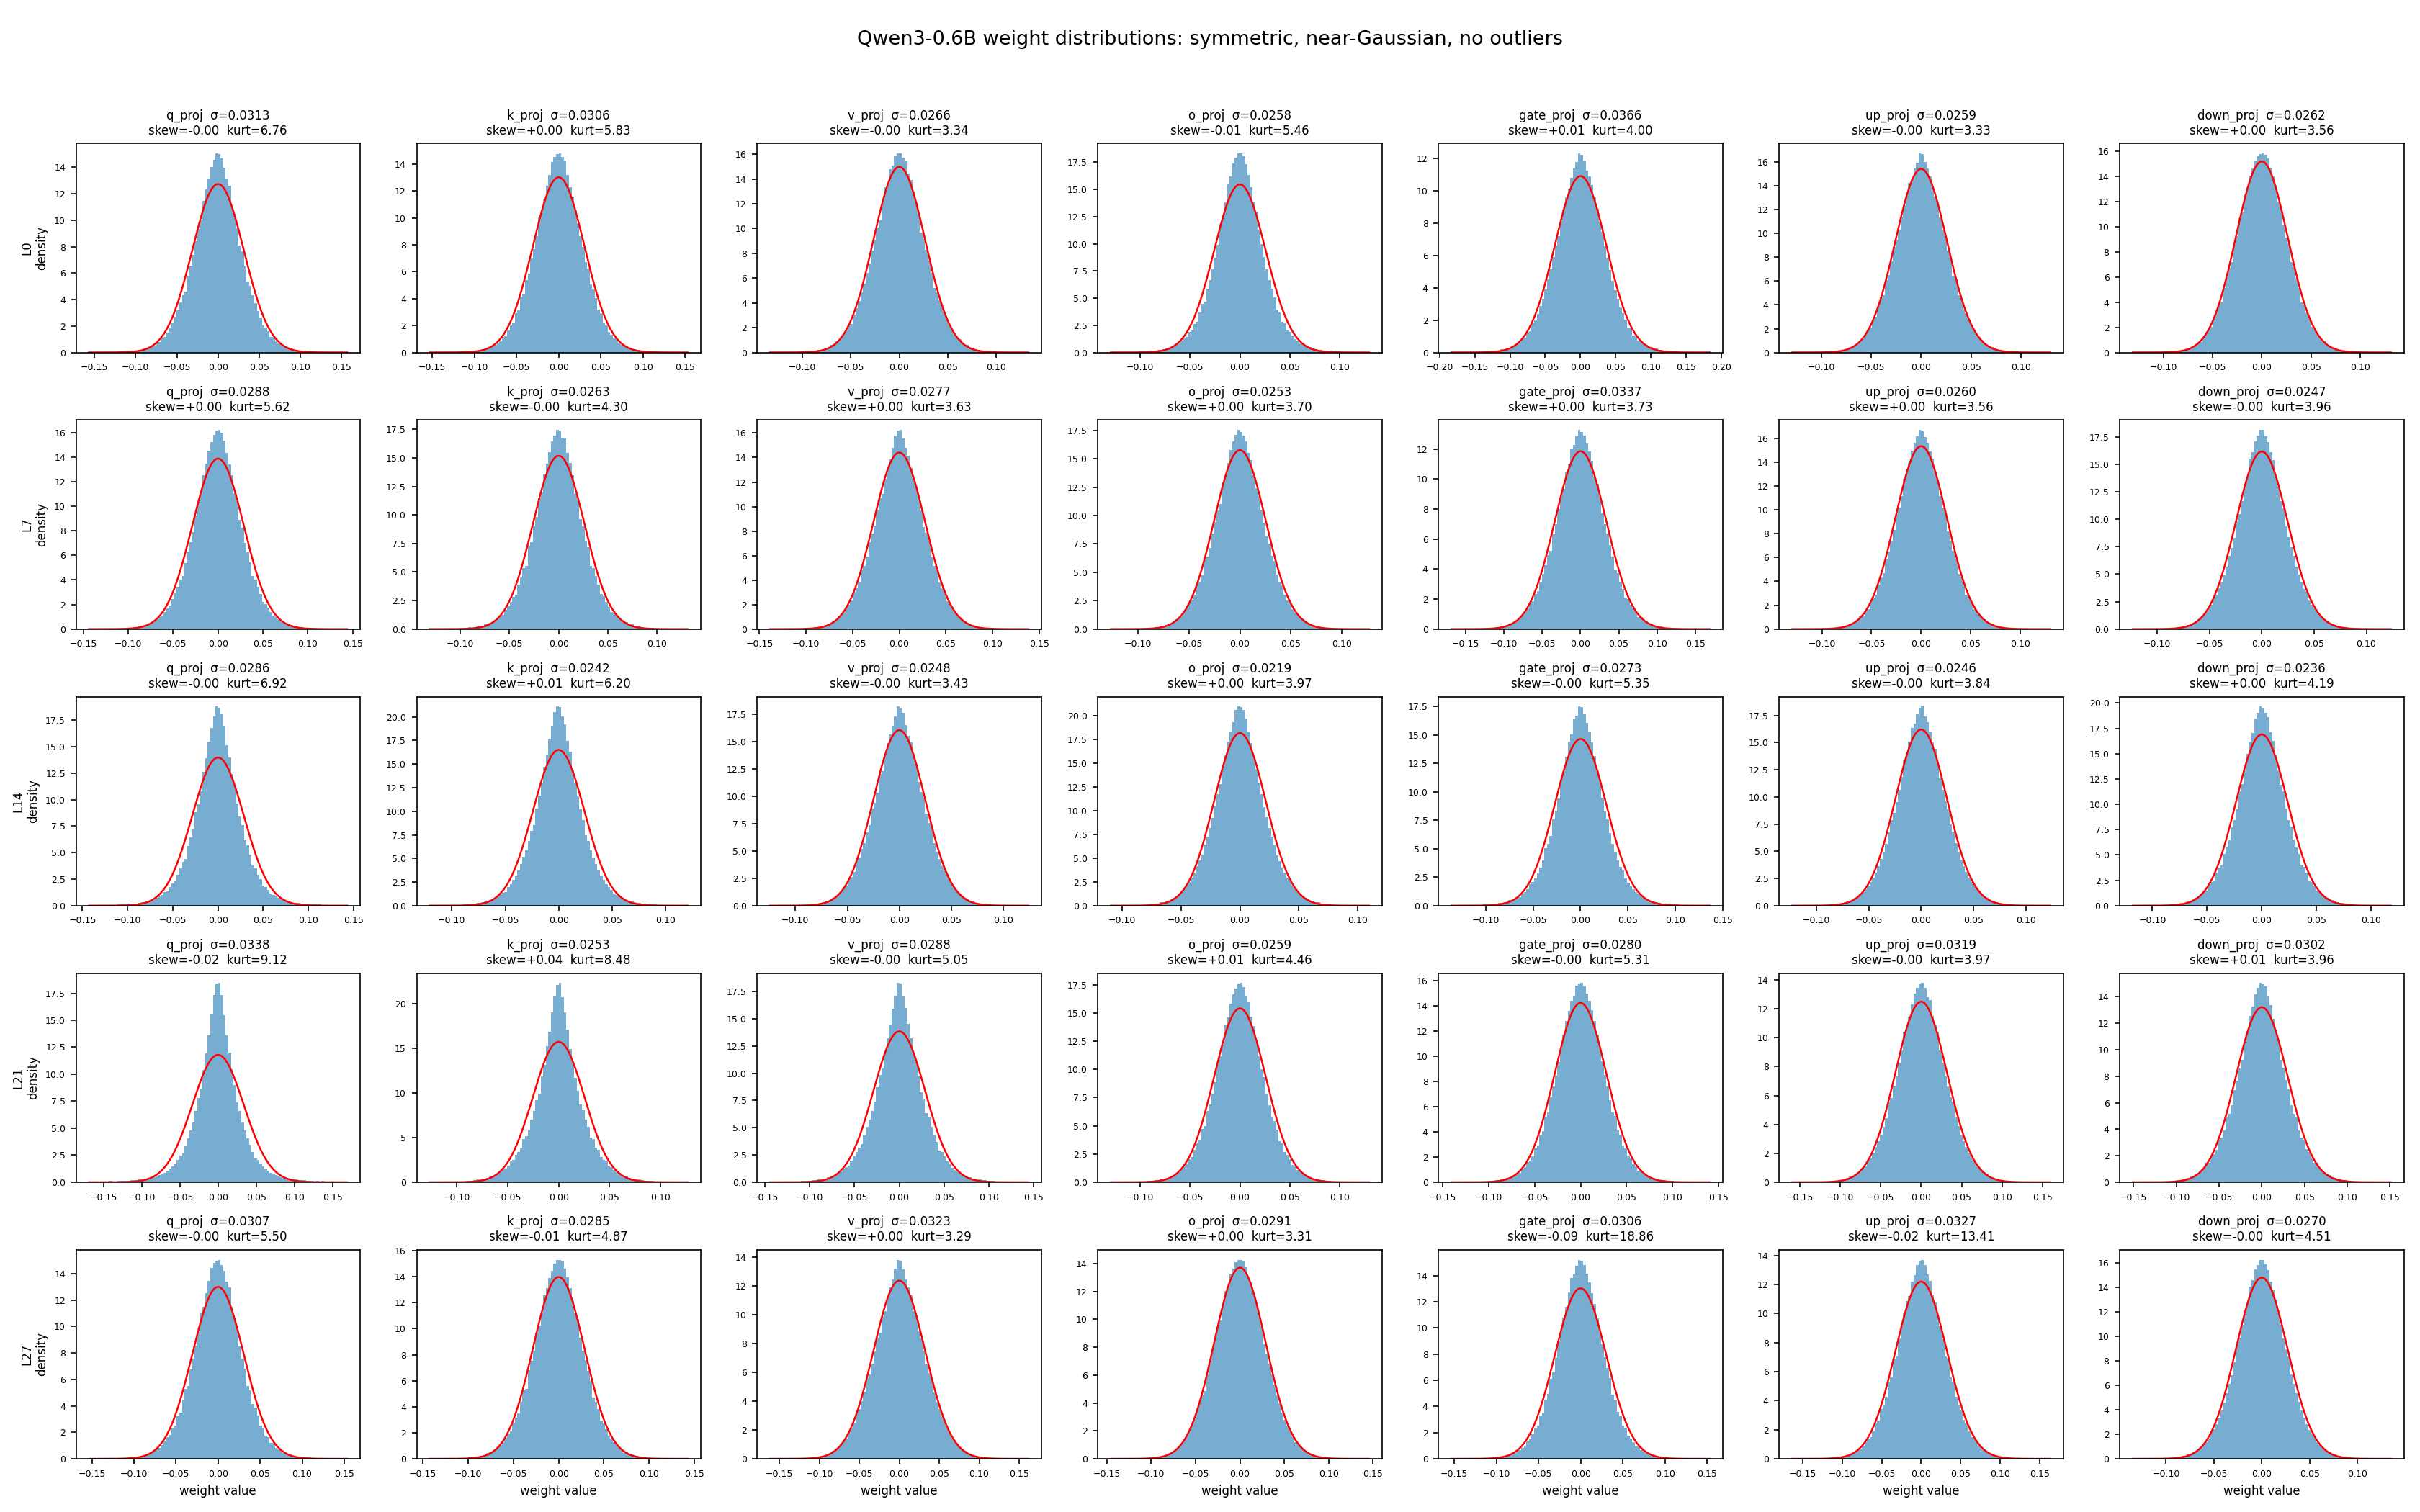
下面列出了部分权重的统计结果:
==================================================================================
layer                                           std     |min|     |max|   max/mean
==================================================================================
model.layers.0.self_attn.q_proj              0.0313  7.20e-10  6.45e-01       3.6x
model.layers.0.self_attn.k_proj              0.0306  5.09e-09  4.34e-01       3.8x
model.layers.0.self_attn.v_proj              0.0266  1.07e-08  1.73e-01       1.3x
model.layers.0.self_attn.o_proj              0.0258  4.51e-09  4.22e-01       2.7x
model.layers.0.mlp.gate_proj                 0.0366  2.46e-08  3.91e-01       2.0x
model.layers.0.mlp.up_proj                   0.0259  6.11e-09  3.75e-01       1.4x
model.layers.0.mlp.down_proj                 0.0262  8.79e-09  4.18e-01       2.3x
model.layers.7.self_attn.q_proj              0.0288  6.26e-09  3.96e-01       3.8x
model.layers.7.self_attn.k_proj              0.0263  8.57e-08  2.71e-01       2.2x
model.layers.7.self_attn.v_proj              0.0277  3.40e-08  5.08e-01       1.4x
model.layers.7.self_attn.o_proj              0.0253  6.22e-10  3.34e-01       2.3x
model.layers.7.mlp.gate_proj                 0.0337  8.61e-09  3.30e-01       2.2x
model.layers.7.mlp.up_proj                   0.0260  2.42e-09  2.89e-01       1.9x
model.layers.7.mlp.down_proj                 0.0247  6.23e-09  5.70e-01       2.8x
model.layers.14.self_attn.q_proj             0.0286  1.46e-08  3.48e-01       3.2x
model.layers.14.self_attn.k_proj             0.0242  5.17e-10  3.44e-01       2.4x
model.layers.14.self_attn.v_proj             0.0248  1.01e-07  1.52e-01       1.3x
model.layers.14.self_attn.o_proj             0.0219  7.28e-09  2.79e-01       2.6x
model.layers.14.mlp.gate_proj                0.0273  9.02e-09  4.36e-01       2.4x
model.layers.14.mlp.up_proj                  0.0246  6.05e-09  3.36e-01       1.8x
model.layers.14.mlp.down_proj                0.0236  5.82e-09  3.48e-01       2.9x
model.layers.21.self_attn.q_proj             0.0338  3.07e-08  4.02e-01       3.3x
model.layers.21.self_attn.k_proj             0.0253  2.01e-08  6.29e-01       2.3x
model.layers.21.self_attn.v_proj             0.0288  1.86e-08  2.58e-01       2.0x
model.layers.21.self_attn.o_proj             0.0259  3.48e-09  3.05e-01       2.2x
model.layers.21.mlp.gate_proj                0.0280  1.26e-08  6.17e-01       2.2x
model.layers.21.mlp.up_proj                  0.0319  5.94e-09  6.25e-01       1.6x
model.layers.21.mlp.down_proj                0.0302  1.92e-09  6.02e-01       2.0x
model.layers.27.self_attn.q_proj             0.0307  9.37e-09  4.28e-01       3.0x
model.layers.27.self_attn.k_proj             0.0285  2.01e-08  6.84e-01       2.0x
model.layers.27.self_attn.v_proj             0.0323  4.96e-08  2.62e-01       1.2x
model.layers.27.self_attn.o_proj             0.0291  7.28e-09  3.05e-01       1.6x
model.layers.27.mlp.gate_proj                0.0306  9.31e-09  1.16e+00       8.2x
model.layers.27.mlp.up_proj                  0.0327  1.70e-08  1.23e+00       7.6x
model.layers.27.mlp.down_proj                0.0270  1.29e-08  5.55e-01       1.8x
可以看到权重的分布相对集中,大都落在 0 附近的一个较小区间内,没有特别大的异常值。分布这么集中,量化误差通常就小。
但激活值的分布通常比权重更分散,其中还夹着少量幅值特别大的异常值。下图是部分激活的数值分布:
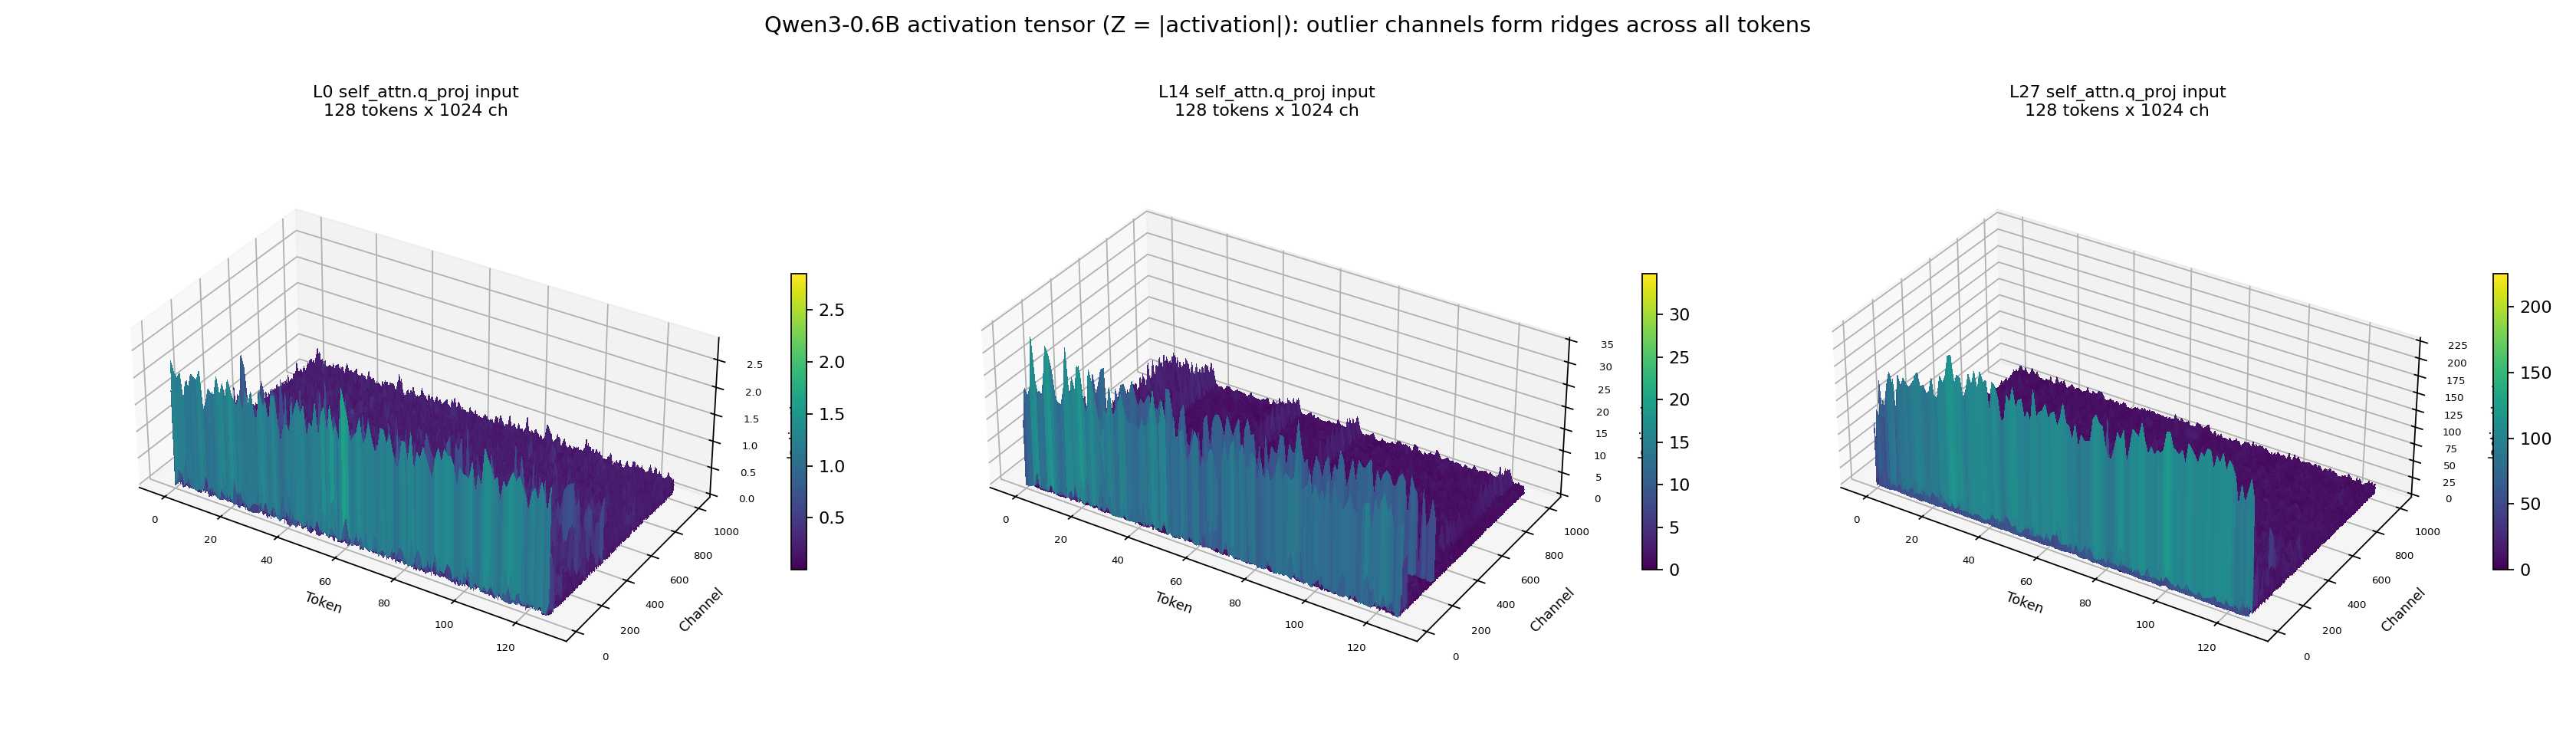
这里我统计了某几层激活值的分布,其中 |Abs|P50 和 |Abs|P99 分别是激活绝对值的中位数和 99 分位数:
                       Hook    #Elements         Min         Max   |Abs|P50   |Abs|P99
--------------------------------------------------------------------------------------
         L0.input_layernorm       83,968     -3.2344      2.2500    0.12061    0.68750
    L0.post_attention_layernorm   83,968    -11.5000      2.5781    0.22461    1.15625
        L0.self_attn.q_norm      167,936    -32.7500     37.0000    0.76953    7.71875
          L0.self_attn.k_norm     83,968   -456.0000    476.0000    0.89844   60.25000
    L5.post_attention_layernorm   83,968    -16.5000     20.7500    0.40234    2.17188
             L5.self_attn.k_norm  83,968   -119.0000    105.0000    0.89062   57.50000
这些图和数据说明,激活值的分布范围比权重更大。比如 L0 的 k_norm 层,最小值 -456,最大值 476,但有一半数值的绝对值不超过 0.9。范围这么宽,逐张量量化很容易被少数异常值带偏,引入较大的量化误差。
观察激活值的 3D 分布图可以发现,较大的值往往集中在特定通道上。因此,使用 per-channel 量化时,每个通道都有独立的量化范围,异常值的影响可以局限在对应通道,从而减小大部分激活值的量化误差。
下面统计了某一层的激活值在 channel 维度和 token 维度上的分布:
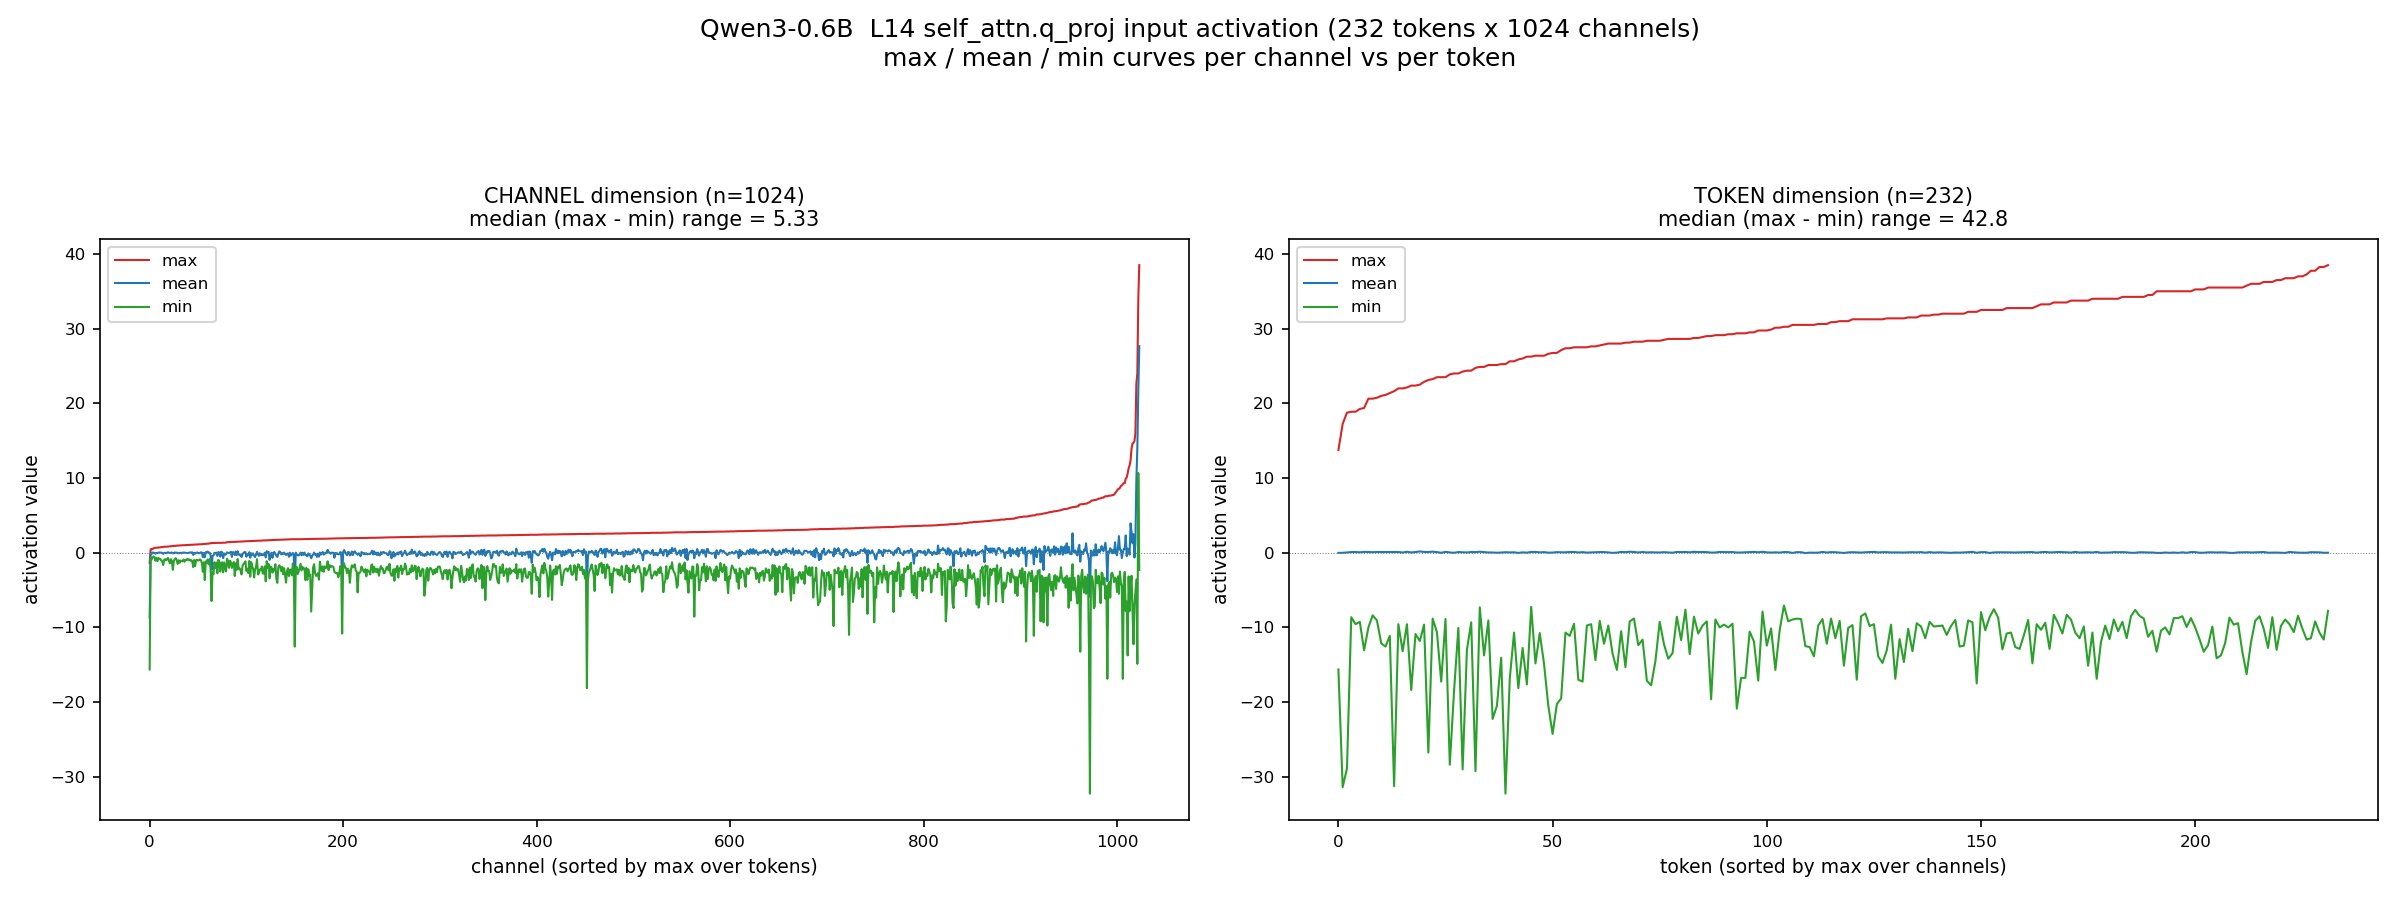
某些通道里存在较大的值,按 token 量化时,取到这些大值的 token 会被迫采用更大的量化范围。
为什么激活不能用逐通道量化
当权重和激活值都量化到 INT8 后,矩阵乘法可以交给 INT8 Tensor Core 加速,算完再反量化回 FP16 供后续使用。要吃到 INT8 Tensor Core 的收益,反量化就必须放到矩阵乘之后。
为了降低量化误差,直觉上可以对激活值使用 per-channel 量化,因为每个通道的数值范围更小。但逐通道量化会为每个通道引入独立的缩放因子,矩阵乘法完成后,结果矩阵的每一行都受到多个缩放因子的影响,无法通过一次反量化操作恢复真实值。因此,为了高效计算,激活值需要使用 per-tensor 或 per-token 量化,而权重可以使用 per-channel 量化。这样才能利用 INT8 高效执行矩阵乘法。
下面是计算流程的示意图:
矩阵左乘时,左侧矩阵的每一行对右侧矩阵的各行做加权求和,所以结果矩阵每一行的缩放因子与左侧矩阵对应行一致。矩阵右乘时,右侧矩阵的每一列对左侧矩阵的各列做加权求和,所以结果矩阵每一列的缩放因子与右侧矩阵对应列一致。
整个过程可以用下面的公式表示:
于是形成了一个僵局:要减小异常值对激活量化的影响,可以采用逐通道量化;但为了高效执行矩阵乘法,硬件又要求激活使用逐张量或逐 token 量化。
SmoothQuant 的原理
激活中的异常值会拉大量化步长,增大量化误差;但受硬件计算方式限制,又无法通过 per-channel 量化来缓解这一问题。SmoothQuant 会整体缩小激活异常值所在通道的数值幅度,使其更接近其他通道,从而避免异常值显著拉大 per-tensor 或 per-token 量化的步长。为了保持输出不变,它还会整体放大权重中对应通道的数值幅度,将激活量化的部分难度转移到权重上。
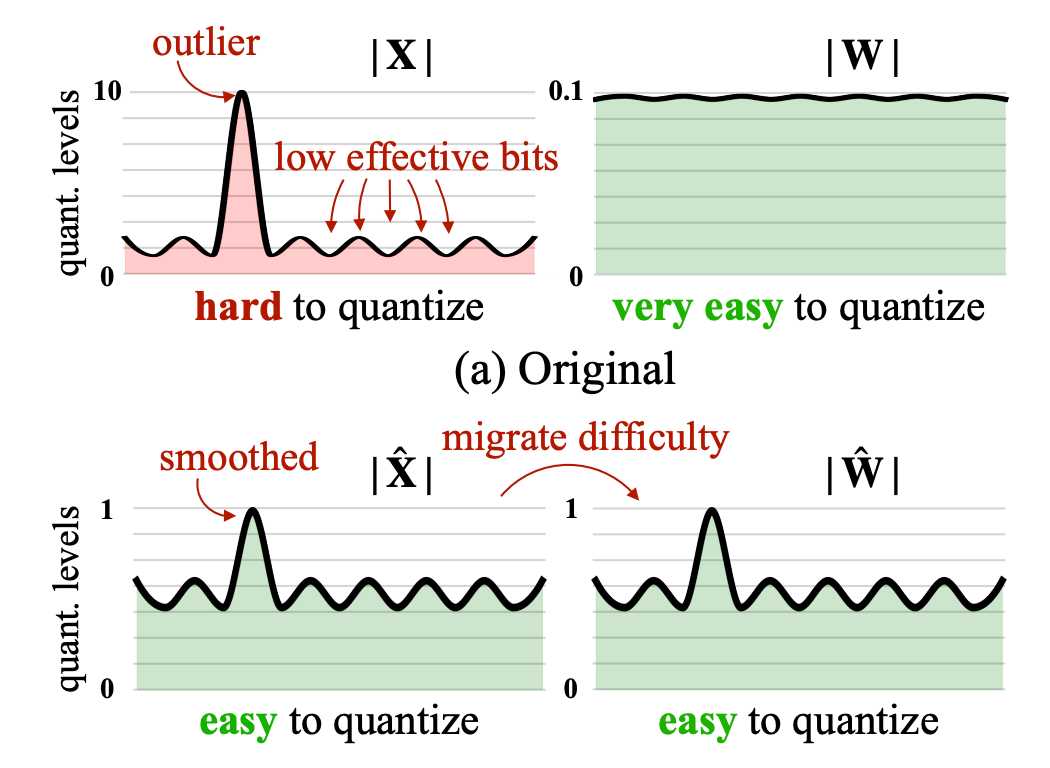
对 ,引入一个对角矩阵:
在线性层中插入它的逆和它本身:
这个变换做的事情是:
- :把 的第 列整体除以 ;
- :把 的第 行整体乘以 。
因为 是对角矩阵, 也是对角矩阵,且 是单位矩阵,所以这一变换不会改变输出 。在实数域中,两种写法严格等价。也就是说,我们可以在激活的通道 与权重对应的通道 之间重新分配数值幅度。
这和 AWQ 用的是同一个恒等式,只是写法不同、目标也不同。AWQ 面向 W4A16,激活根本不量化,缩放只是为了给重要的权重列争取更高的量化分辨率。SmoothQuant 面向 W8A8,缩放是为了把激活的动态范围整体压下来,让激活也能被量化。
缩放因子
现在的问题是 该取多少。记:
即 是第 个输入通道上激活的最大幅度, 是权重第 行的最大幅度。缩放之后:
越大,激活一侧越容易量化,权重一侧则越难。一个自然的选择是让两侧的最大幅度相等:
解得:
引入一个在 之间的超参数 ,把上式推广成:
控制的是难度往权重那边迁移多少:
- :,权重每行的最大值被归一化为 1,激活范围反而变成 ,难度全压在激活上,等于没做平滑;
- :,两边范围相等,难度均分;
- :,激活每列的最大值被归一化为 1,权重行最大值变成 ,难度全压在权重上。
缩放的代价
缩放不能凭空消除误差,只是把量化难度从激活转移到权重。那么,这会给权重量化带来多大代价?
看权重这一侧。第 行被整体放大了 倍,如果权重使用逐通道量化,这一行的量化步长也从 变成 ,绝对误差同样放大了 倍,看起来是变差了。但反过来看相对误差:
被约掉了。逐通道量化对通道内的统一缩放是免疫的,权重该有多少相对精度,缩放之后还是多少。缩小激活通道的代价,在权重这一侧恰好是零。而激活这一侧因为全局最大值从 变成了 ,逐张量量化的步长随之下降,从而减小了量化误差。
缩放的效果
抽象地看不够直观,代入一组数字。假设某个线性层有两个输入通道,权重两行的最大幅度都是 :
| 通道 A(异常通道) | 通道 B(正常通道) | |
|---|---|---|
| 激活最大值 | 100 | 0.5 |
| 权重行最大值 | 0.01 | 0.01 |
平滑之前,逐张量量化的步长由通道 A 决定:
通道 B 中一个 的激活值,量化后是 ,反量化回来是 ,误差 ,相对误差接近 100%。
取 平滑之后,两个通道的缩放因子分别是:
缩放后两边范围恰好相等:通道 A 的激活最大值变成 ,权重行最大值变成 ;通道 B 的激活最大值变成 ,权重行最大值也是 。
激活的全局最大值从 100 降到 1,量化步长随之变成:
还是通道 B 里那个 的激活值,缩放后是 ,量化后是 ,反量化为 ,再乘回 得到 ,误差 ,相对误差约 2.5%。
同一个数值,相对误差从 100% 降到 2.5%。而权重那一侧付出的代价是零,因为逐通道量化对缩放免疫。
将对激活的缩放融入前序算子
到这里,算法在数学上已经完整了:量化前对权重做一次 缩放,推理时对激活做一次 缩放,中间用 INT8 计算。
但如果在推理时显式计算 ,就需要对每个激活张量额外做一次逐通道除法,并把结果再读写一遍。激活读写本就是 LLM 推理中带宽开销最大的部分之一,这些额外开销很可能抵消 INT8 带来的收益,甚至导致整体性能下降。
SmoothQuant 真正的工程价值在于:对激活值的缩放可以融入到前序算子中去,推理时不需要额外的计算节点,也不需要额外的读写开销。
融入 LayerNorm
Transformer 中,q/k/v 投影的输入来自 input_layernorm 的输出。这里的 LayerNorm 通常采用 RMSNorm,其公式为:
我们希望它的输出变成 。这只需要对参数做一次缩放:
代入后:
这正是我们需要的结果。LayerNorm 本来就要进行逐元素的缩放和平移,替换参数不会增加额外计算。而且,残差连接使用的是 LayerNorm 的输入,而不是输出;因此,修改 和 只会影响后续的注意力分支,不会改变残差流。
同理,post_attention_layernorm 后面跟着的是 gate_proj 和 up_proj,也按同样方式折叠。
融入前序线性层的权重
MLP 的结构是:
down_proj 的输入需要在第 个通道上缩小为原来的 。由于 是非线性的逐元素函数,缩放只能施加在激活函数输出之后,也就是 这一路上。具体来说,将 第 个输出通道对应的权重乘以 ,逐元素相乘后,中间激活的第 个通道也会缩小为原来的 。为了保持 down_proj 的结果不变,还要将其对应输入通道的权重乘以 。这样,中间激活的 与 down_proj 权重的 相互抵消,FFN 的最终输出保持不变。
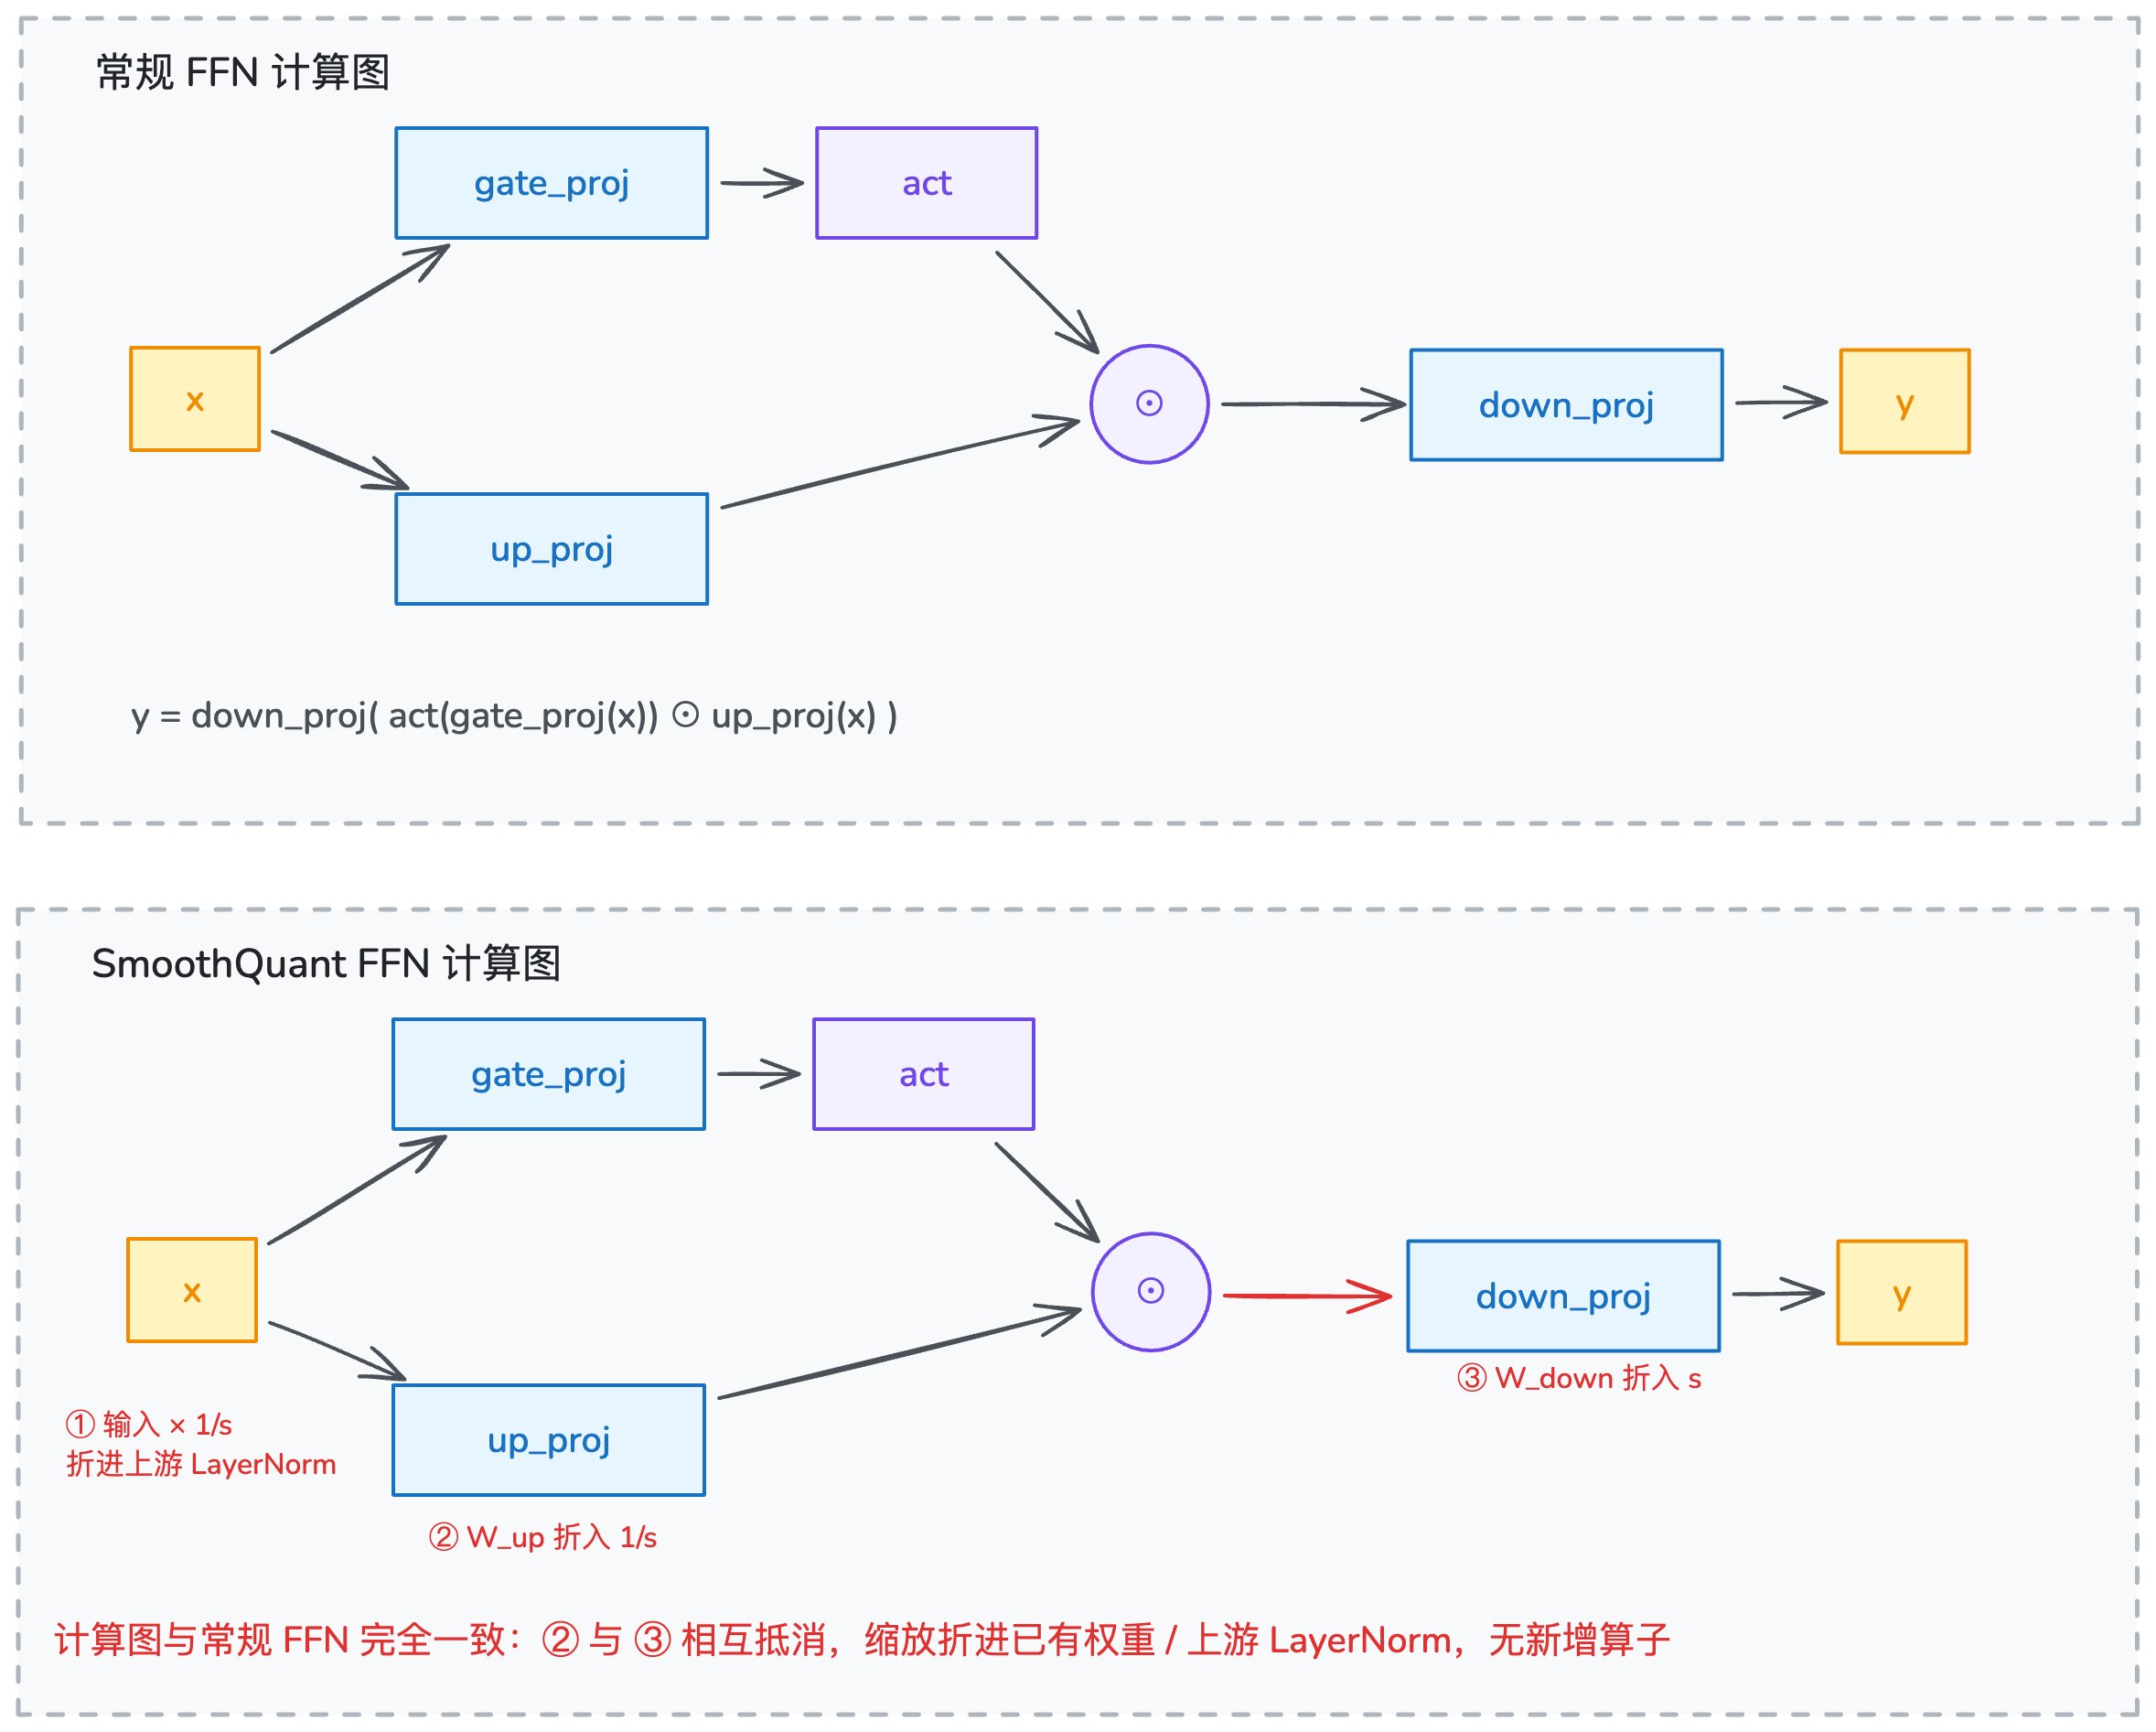
需要平滑的层与折叠位置
把上面几种情况汇总起来,一个 Transformer 层中需要平滑的线性层及其缩放折叠位置如下:
| 线性层 | 输入来源 | 缩放折叠到 |
|---|---|---|
| q_proj / k_proj / v_proj | input_layernorm | LayerNorm 的 和 |
| gate_proj / up_proj | post_attention_layernorm | LayerNorm 的 和 |
| down_proj | up_proj 的输出通道权重 | |
| o_proj | 注意力输出( 的加权平均) | v_proj 的输出通道权重 |
gate_proj 和 up_proj 共享同一个输入,所以缩放 x 时,只能用 gate_proj 和 up_proj 中其中一个算出的缩放因子。
效果与局限
论文在 OPT、BLOOM、GLM、Llama 等模型上验证了 SmoothQuant,主要结论有两点:采用 W8A8 静态逐张量量化时,模型困惑度相较 FP16 几乎没有损失;如果不做平滑,直接对激活进行逐张量 INT8 量化,困惑度则会显著恶化,在较大的模型上甚至会让模型完全不可用。由此可见,平滑是 W8A8 能否成立的关键步骤。
收益取决于具体场景。在 prefill 和大批量场景下,计算通常是瓶颈,INT8 GEMM 的吞吐优势可以转化为端到端加速;在小批量解码时,推理仍受内存带宽限制,瓶颈在于读取权重。此时,W4A16 这类权重量化方法往往比 W8A8 更划算,因为它们能进一步降低权重位宽。因此,SmoothQuant 与 GPTQ、AWQ 并非相互替代,而是适用于不同的推理场景。
SmoothQuant 也有明确的局限:对于异常值特别极端的层(例如前面提到的 k_norm),即使经过平滑,激活范围仍可能偏大,导致该层的量化误差明显高于其他层。平滑依赖“异常值在通道维度上相对稳定”这一前提;如果某些层的异常值位置随输入变化较大,校准阶段统计出的 就难以代表推理时的分布。
与相关方法的关系
把几类方法放在一起对比,能更清楚地看到 SmoothQuant 的位置:
| 方法 | 量化对象 | 处理激活异常值的方式 | 推理时是否引入额外算子 |
|---|---|---|---|
| LLM.int8() | W8A8(部分通道 FP16) | 把含异常值的通道单独拆出来用 FP16 计算 | 需要,混合精度矩阵乘 |
| GPTQ | W4A16 | 逐列量化并用剩余列补偿误差 | 否 |
| AWQ | W4A16 | 按激活幅度缩放权重列,保护重要通道 | 否 |
| SmoothQuant | W8A8 | 等价变换,把异常值从激活迁移到权重 | 否,缩放可折叠进前序算子 |
与 AWQ 的关系尤其值得说明。两者使用同一个恒等式 ,操作方向也一致,都是放大权重列、缩小对应的激活通道;区别在于目标:
- AWQ 面向 W4A16,激活不量化。缩放的作用是让重要权重列在共享的量化网格中占据更大范围,从而获得更多整数等级。AWQ 所保护的重要权重列,通常对应激活值较大的通道。因此,SmoothQuant 和 AWQ 使用的缩放依据相近,但两种算法的目标不同。
- SmoothQuant 面向 W8A8,缩放的作用是压低激活动态范围,使逐张量 INT8 量化变得可行。因此,缩放系数不再只由激活幅度决定,而是由激活和权重两侧的范围共同决定。
总结
激活中的异常值集中在少数固定通道上,解决它需要逐通道量化;但 INT8 矩阵乘只允许在计算之后施加逐 token 的缩放,所以对激活值无法真正做逐通道量化。
SmoothQuant 利用线性层的等价变换 ,把激活中幅度大的通道按比例缩小,同时把权重中对应的行按同样的比例放大。逐通道量化对通道内的统一缩放具有不变性,权重放大多少,量化步长也同比放大,因此相对误差不变。与此同时,激活中的异常值被压缩,逐张量量化的步长随之减小,激活量化误差也因此降低。
推理时,对激活的缩放可以折叠进前序算子,例如融入 RMSNorm 的参数或前序线性层的输出通道权重中,因此不会增加额外计算。这正是 SmoothQuant 能在 W8A8 下实现加速的原因。